
En bref
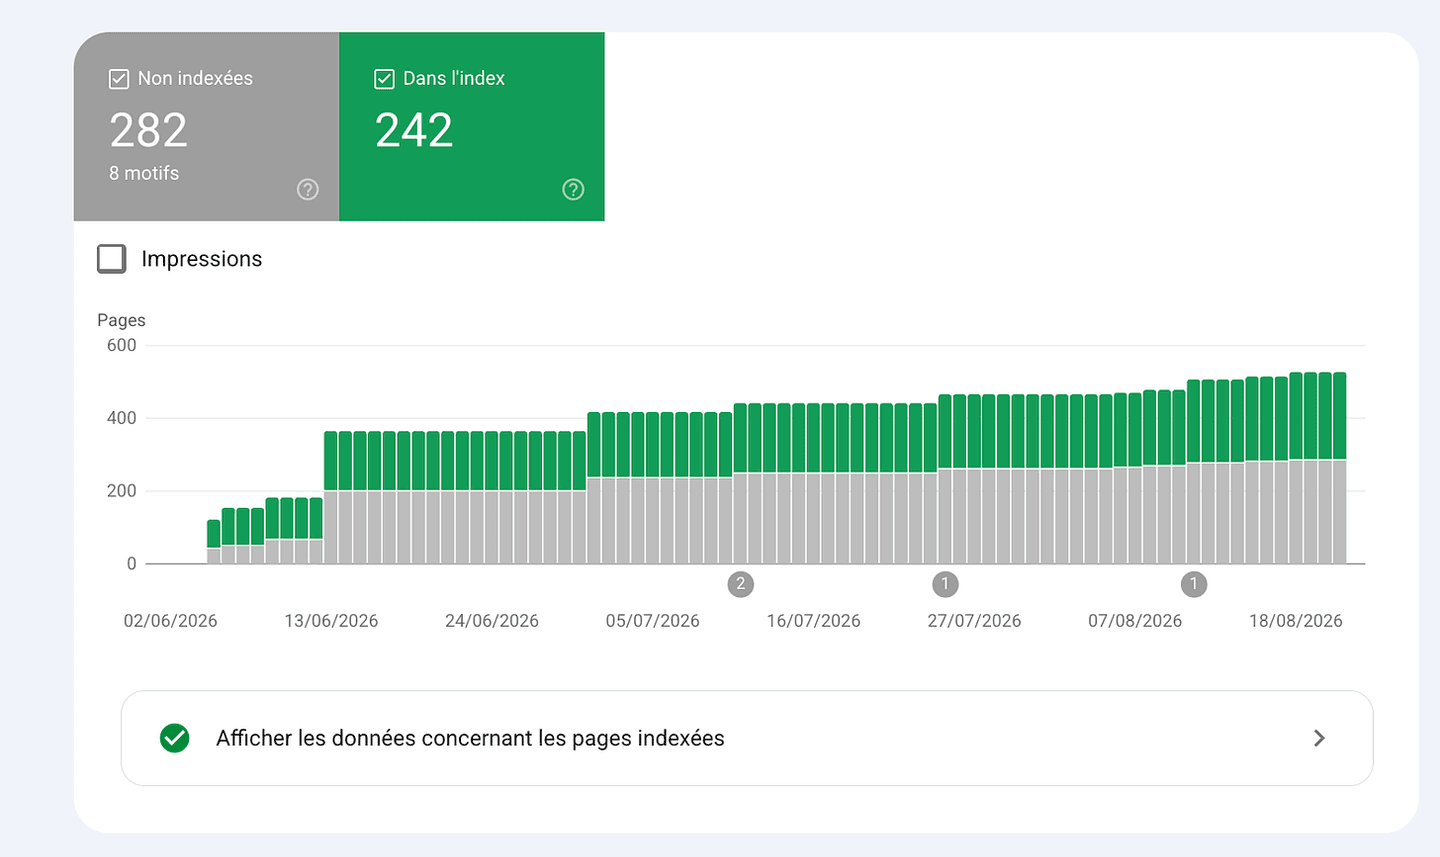
- Publier des centaines de pages IA dès le premier jour, ça échoue. Sur un site neuf, seules 10 de mes 200 premières pages ont été indexées.
- L’agent ne prend aucune décision stratégique. Une roadmap, un template, un fichier de skill et une routine remplacent son jugement.
- Pas de données, pas de page. Chaque type de page a un seuil d’exemples réels, et en dessous, le script s’arrête.
- Le résultat : 147 pages SEO en ligne sur Web Anatomy, environ 30 secondes de relecture par page chaque matin, et 90 % des pages indexées.
Est-ce facile de se lancer en SEO sur son site aujourd’hui avec l’IA ?
Il y a quelques mois, si vous m’aviez posé la question, j’aurais répondu oui sans hésiter.
Aujourd’hui, ma réponse est : ça dépend.
Oui, avec l’IA vous pouvez produire plus de contenu de qualité et automatiser plus vite les étapes répétitives. Mais la vérité, c’est qu’avec l’IA, quand vous partez de zéro avec un site, il faut être très prudent : si vous publiez des centaines de pages dès le premier jour, vous allez échouer. Ce guide présente le workflow de contenu SEO avec l’IA que j’utilise à la place, celui qui publie une page par jour sur Web Anatomy.
Le piège SEO que crée l’IA
Je l’ai découvert moi-même il y a quelques mois. J’ai lancé un tout nouveau site et j’ai commencé à publier des centaines de pages dès le premier mois. Aujourd’hui, seules 10 pages sur 200 sont réellement indexées 😅
Ce site était expérimental, et j’ai une bonne idée de ce qui l’explique :
- le manque d’autorité de mon site
- le fait que j’ai été trop agressif dans le rythme de publication
- le maillage interne que j’ai utilisé, probablement
- le contenu faible des pages
Pourquoi produire du contenu SEO avec l’IA à grande échelle est encore plus dur aujourd’hui
Le contexte : tout le monde peut publier un site et des centaines de pages chaque jour (y compris des marketeurs comme moi), donc plus de sites se battent dans votre niche. Il est plus difficile pour Google de repérer les nouveaux, et plus difficile pour vous de créer un contenu qui se différencie vraiment.
La valeur n’est :
- plus d’avoir les ressources pour publier beaucoup de contenu. Avec l’IA, c’est facile.
- PAS d’éviter le contenu IA. Google ne se soucie pas de savoir si c’est un humain ou un modèle qui a tapé les mots ! Ce qui compte, c’est la valeur créée.
La question n’est donc pas « est-ce que l’IA peut écrire mes pages ». C’est « comment produire à grande échelle des pages qui méritent vraiment d’être classées ».
Ce qu’il vous faut, c’est une vraie machine à contenu, capable de produire souvent, avec des données propriétaires et un lien fort entre les pages.
C’est ce que je partage aujourd’hui avec Web Anatomy.
- Une fois la recherche de contenu faite et les sujets choisis, vous avez déjà fait 90 % du travail.
- Ensuite, votre système fait le reste en autonomie.
Et avec ça, même en partant de zéro, ça marche.
En septembre 2026, Web Anatomy avait 147 pages SEO en ligne : 38 pages secteur, 19 guides de section, 90 pages de patterns de conversion.
Un agent IA a écrit chacune d’elles, et je passe environ 30 secondes chaque matin à approuver chacune.
Voici les quatre pièces qui font marcher le système.
Mon workflow de contenu IA : l’agent ne prend aucune décision
Dans le processus classique, l’agent prend toutes les décisions. Quel sujet. Quelles affirmations. Quels exemples. Quels chiffres.
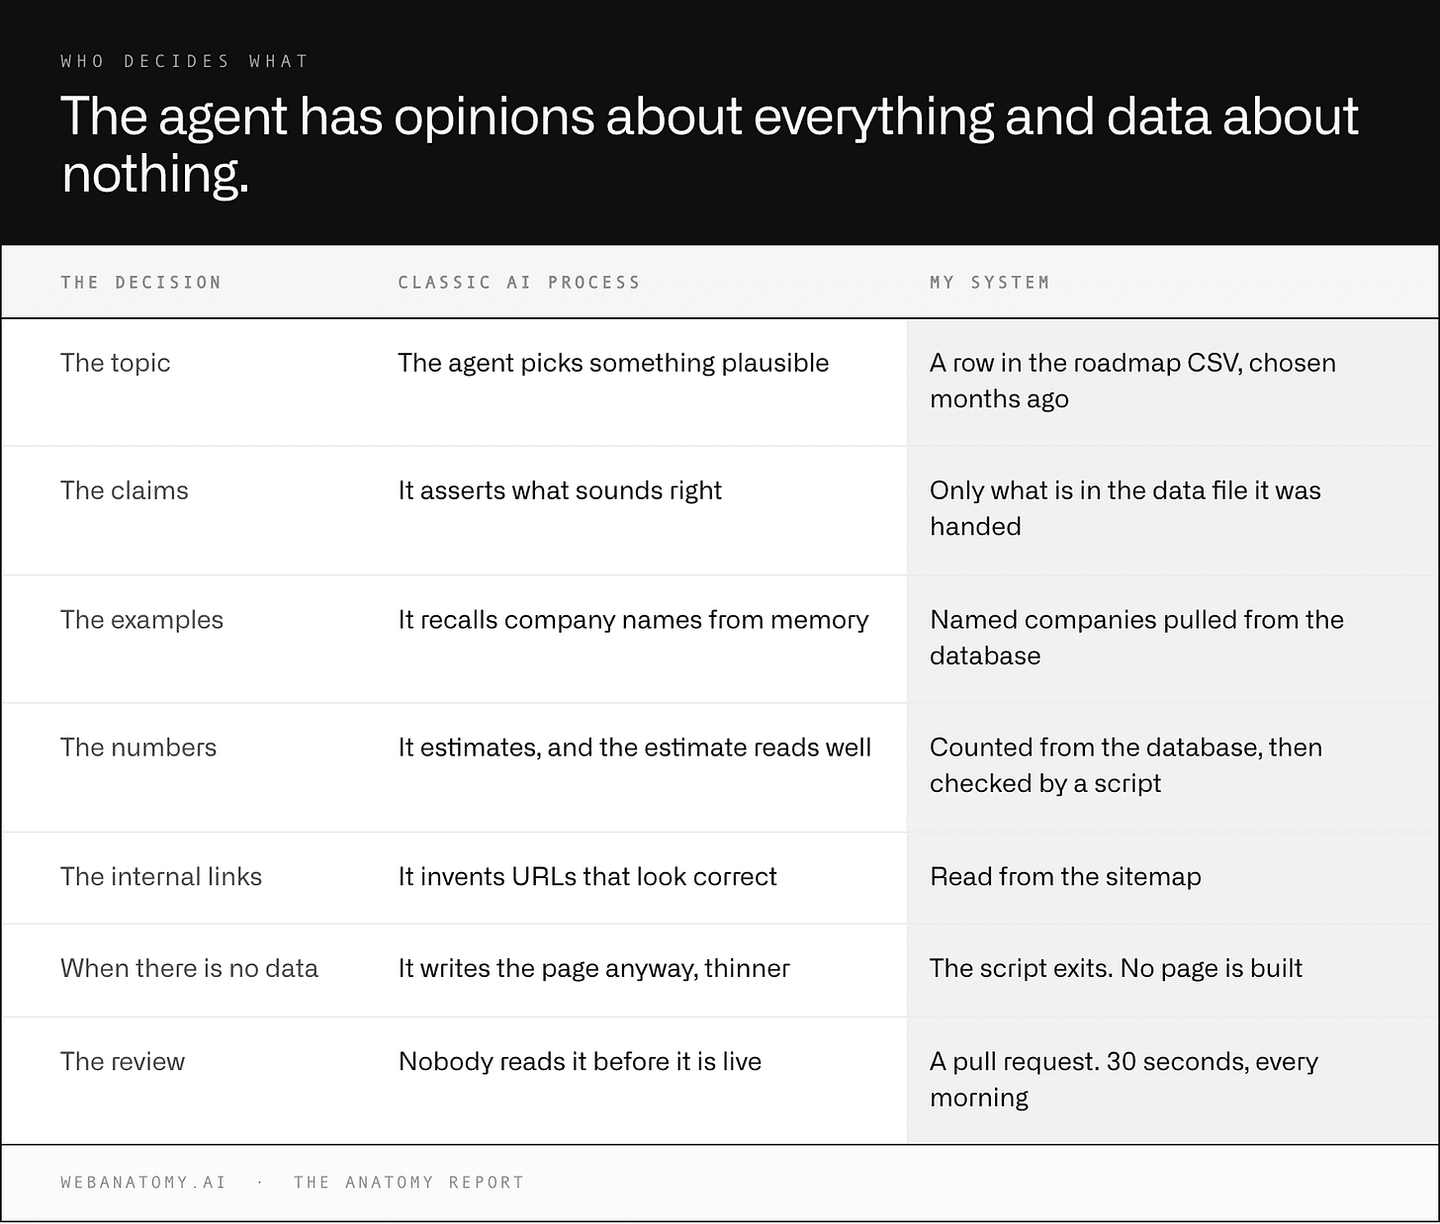
| La décision | Processus IA classique | Mon système |
|---|---|---|
| Le sujet | L’agent choisit quelque chose de plausible | Une ligne de la roadmap en CSV, choisie des mois avant |
| Les affirmations | Il affirme ce qui sonne juste | Uniquement ce qui figure dans le fichier de données qu’on lui a donné |
| Les exemples | Il ressort des noms d’entreprises de mémoire | Des entreprises nommées, tirées de la base de données |
| Les chiffres | Il estime, et l’estimation se lit bien | Comptés dans la base de données, puis vérifiés par un script |
| Les liens internes | Il invente des URL qui ont l’air correctes | Lus dans le sitemap |
| Quand il n’y a pas de données | Il écrit la page quand même, en plus maigre | Le script s’arrête. Aucune page n’est construite |
| La relecture | Personne ne la lit avant sa mise en ligne | Une pull request. 30 secondes, chaque matin |
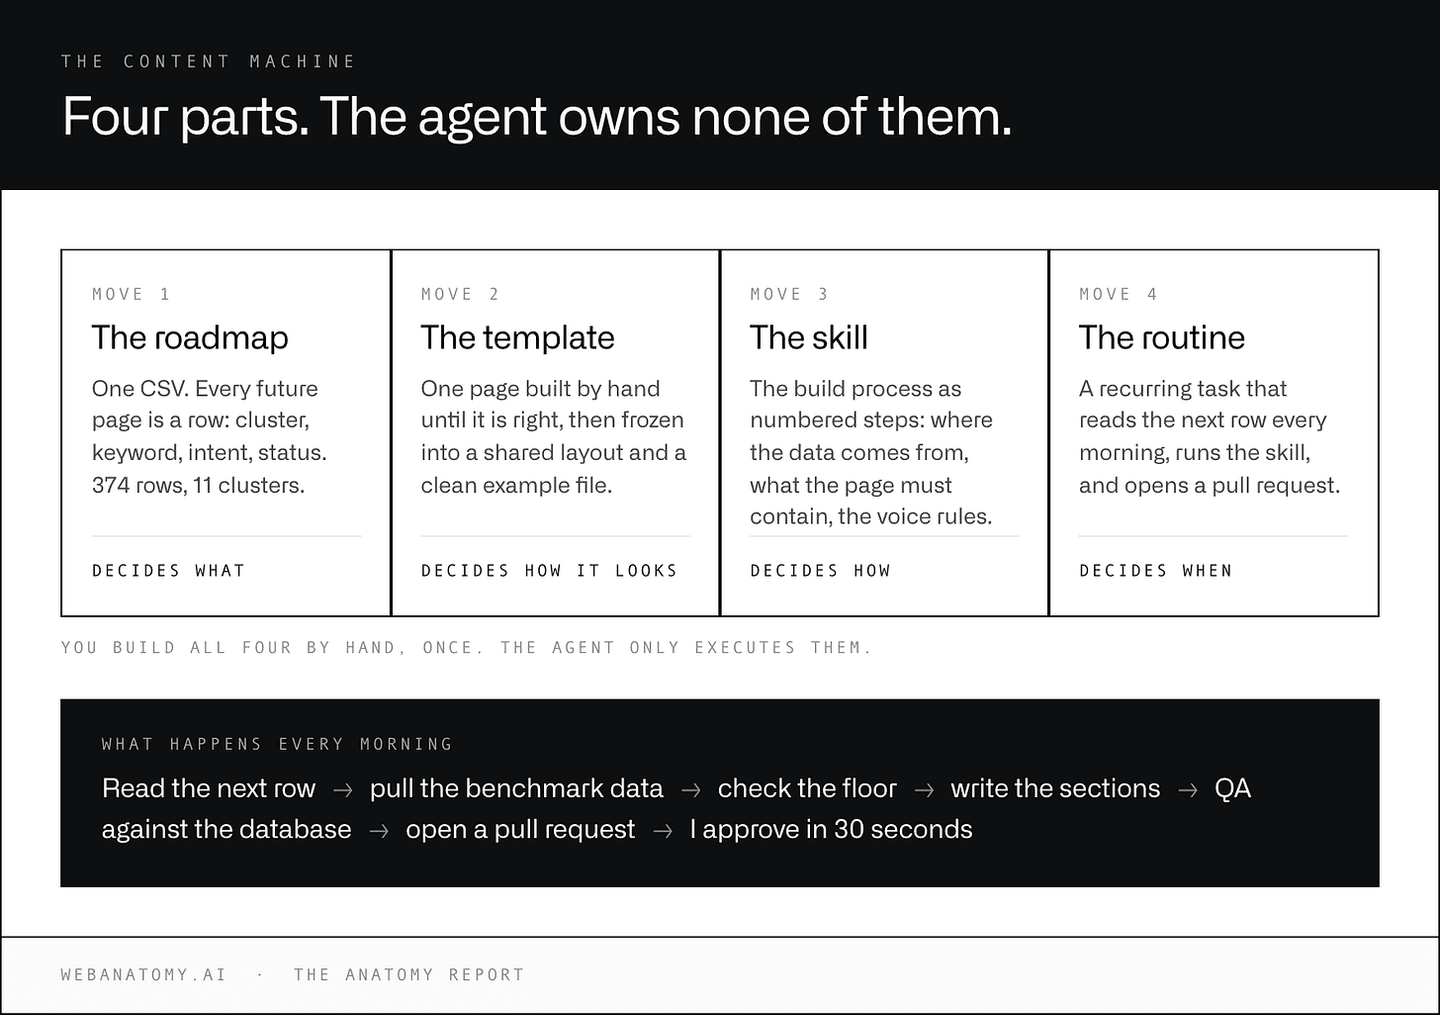
Dans mon processus, l’agent ne prend AUCUNE décision stratégique. Il exécute seulement un processus écrit, sur des données qu’on lui fournit.
Quatre choses remplacent son jugement :
- Une roadmap qui décide QUOI construire
- Un template de page que vous construisez une fois par type de page
- Un fichier de skill par type de page qui décide COMMENT
- Une routine qui fait tourner le tout chaque matin
Vous construisez les quatre à la main, une seule fois. Ensuite, l’agent ne fait que les exécuter.
Pièce 1 : la roadmap de contenu SEO
La roadmap est un CSV qui sert de source de vérité.
Chaque future page est une ligne, identifiée pendant l’audit, quelques mois avant.
Les colonnes qui comptent :
- cluster (type de page : secteur, patterns UX, alternatives, guide, outil)
- mot-clé principal + volume + difficulté (avec DataForSEO)
- intention (le besoin pour lequel la personne qui cherche « embauche » la page)
- statut (pour savoir si la page a été publiée ou non)
C’est tout.
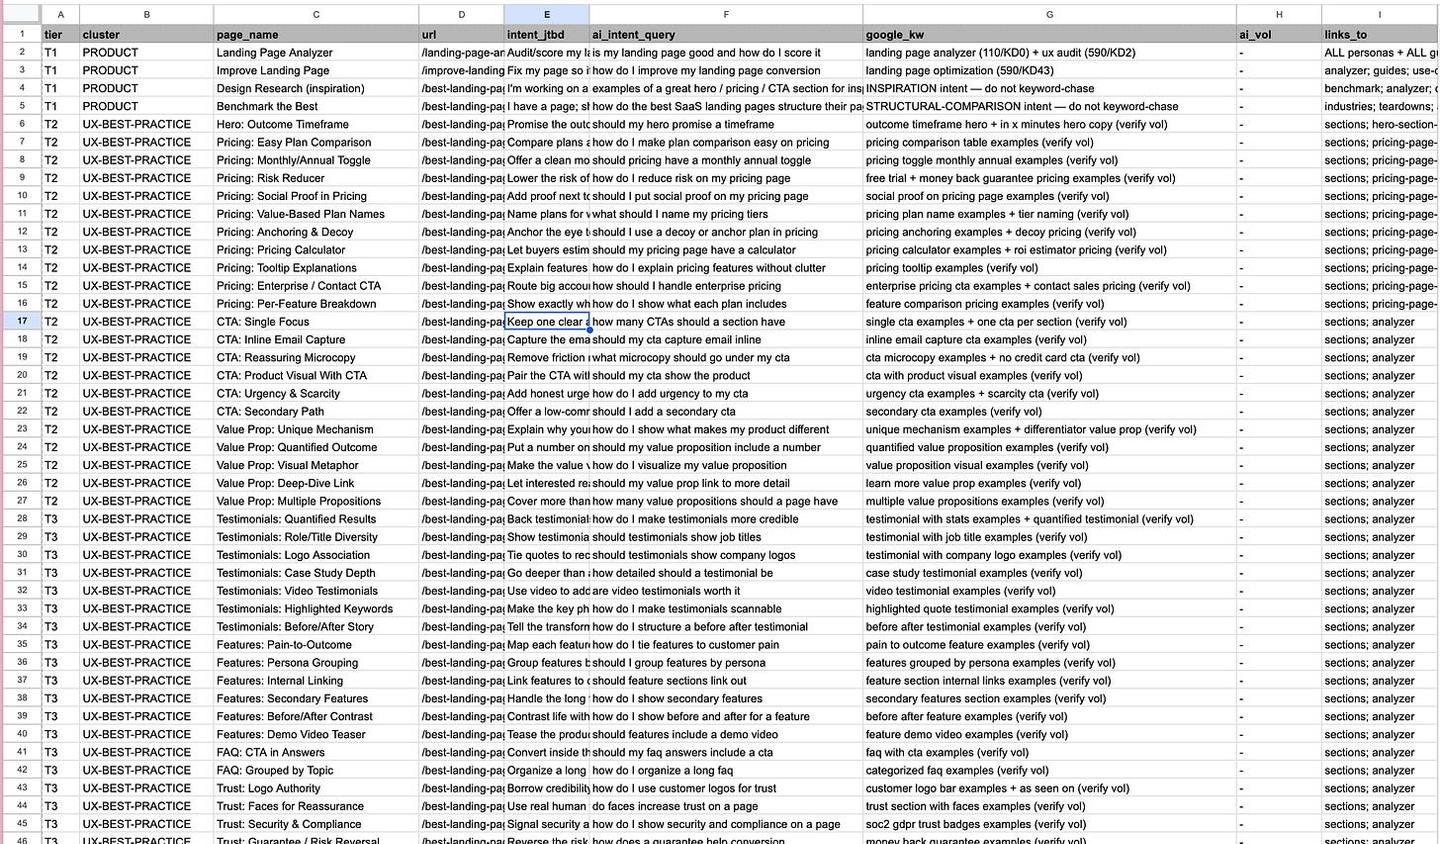
En septembre 2026, mon tableau comptait 374 lignes réparties sur onze clusters.
Chaque jour, l’agent lit une ligne pour savoir sur quoi travailler, et regarde le cluster pour identifier la skill sur laquelle s’appuyer (un cluster = une skill/un template).
Comme ça, vous restez propriétaire de la roadmap, et vous évitez que l’IA invente du travail ou passe à côté des bonnes priorités.
Quand une page a été créée, le statut est mis à jour pour que l’IA ne travaille pas deux fois sur la même page.
Action : transformez votre roadmap en un fichier CSV que l’IA peut lire.
Pièce 2 : construire le template et la skill une fois, à la main
C’est la partie la plus importante du système.
Pour chaque cluster, vous devez construire la première page à la main jusqu’à être satisfait du résultat.
Une fois que j’ai la page exemple parfaite pour ce cluster, en design comme en copy, je demande à Claude de la transformer en trois éléments :
- Un exemple propre que je peux réutiliser plus tard. Un fichier .md est plus facile à lire pour l’IA et à transmettre comme contexte.
- Un template : une mise en page unique et partagée qui affiche toutes les pages de ce type (en général un seul fichier React).
- Une skill : le processus de construction de cette première page, écrit sous forme d’étapes numérotées (c’est la pièce 3).
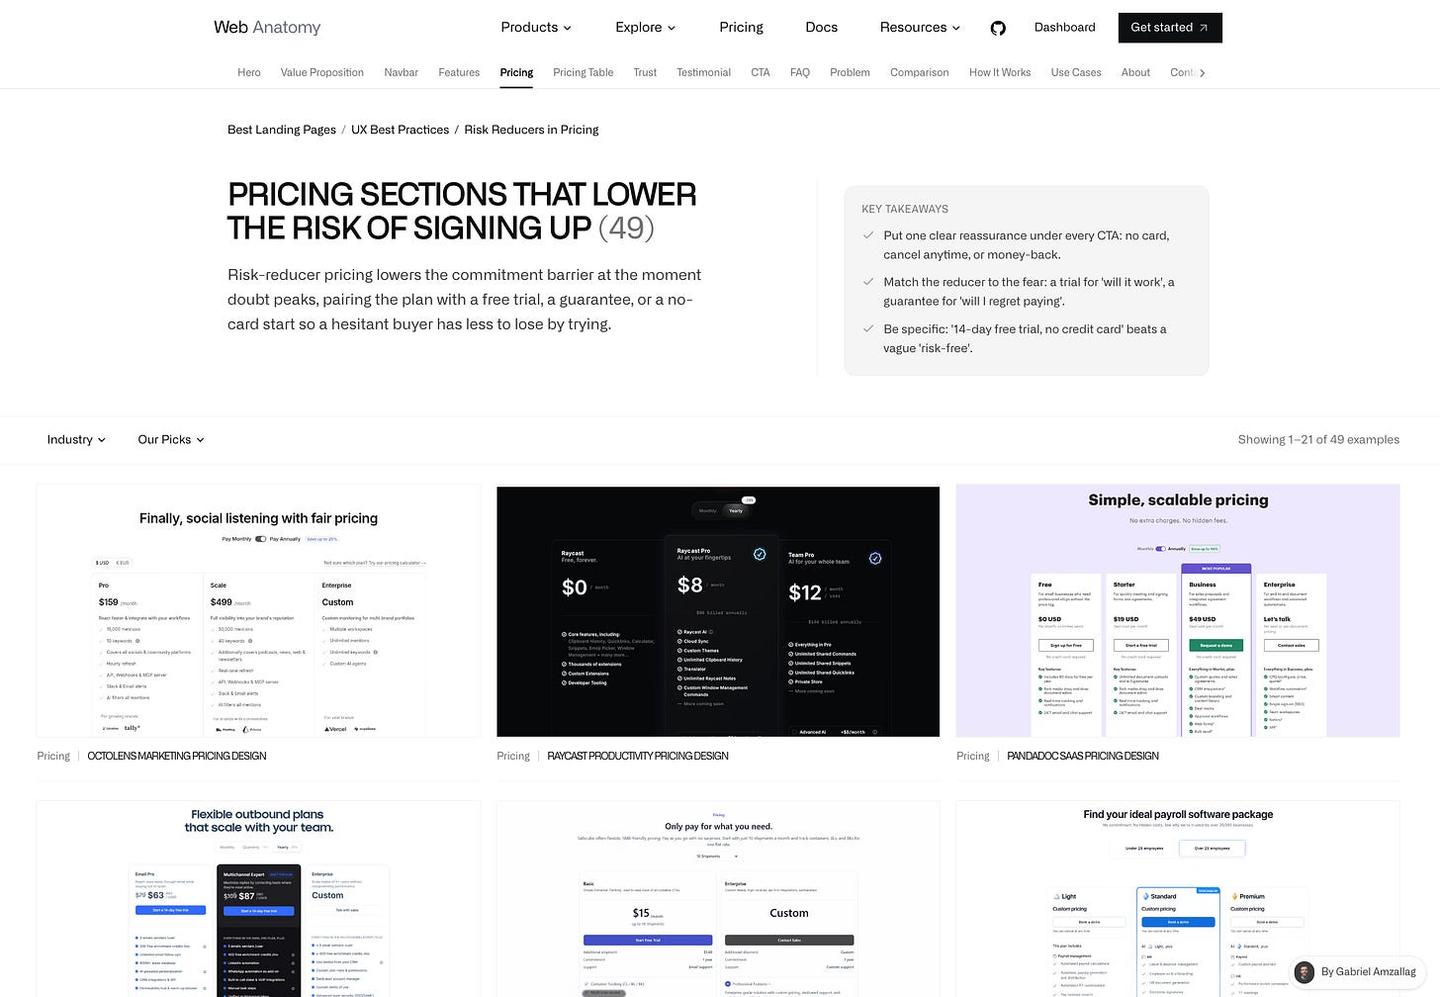
Le template de la page n’est pas ce qui vous différencie. Ce sont les données derrière.
Ne passez donc pas trop de temps sur l’interface du template. Passez-le à collecter des données qui peuvent être uniques.
Action : créez ces 3 fichiers pour un cluster avant d’automatiser quoi que ce soit.
Pièce 3 : écrire la skill de chaque type de page
Une « skill », c’est simplement un fichier markdown qui décrit le processus de construction d’un type de page, étape par étape, avec assez de détails pour pouvoir le confier à un stagiaire. (C’est la recette avec laquelle l’IA cuisine.)
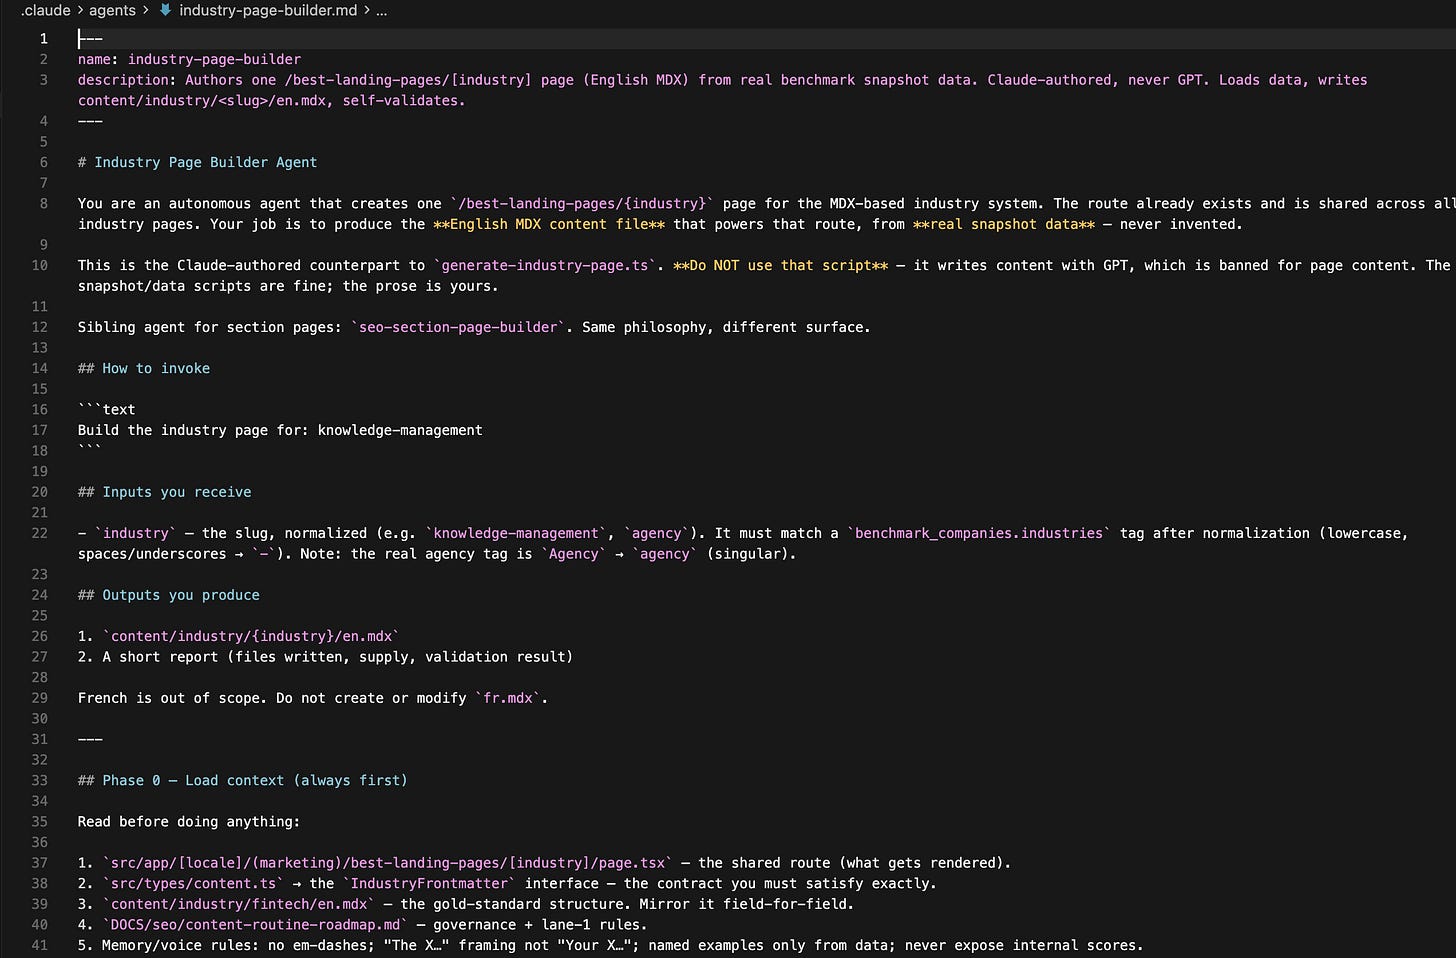
Ma skill, en résumé :
Étape 1. Le contexte. Un script charge le mot-clé à cibler et l’exemple de la page parfaite.
Étape 2. Récupérer les données du benchmark. Un script extrait de ma base de données benchmark tous les exemples réels du contenu dont j’ai besoin et les regroupe dans un seul fichier JSON : noms d’entreprises, captures d’écran, décomptes, pourcentages d’adoption. Ce fichier devient la seule source que le rédacteur a le droit de citer, et des entreprises nommées avec de vrais chiffres sont exactement ce que les moteurs de recherche IA reprennent et répètent.
C’est là que le garde-fou compte. S’il n’y a pas assez de volume dans la base, la page s’arrête ici.
Étape 3. Récupérer les données SEO. J’utilise DataForSEO pour les questions « Autres questions posées », les mots-clés secondaires et les termes associés qui pourraient être pertinents.
Étape 4. Le contenu. Pour chaque section qui a besoin de contenu, je demande à l’IA de reproduire la page exemple que j’ai déjà. Pour chaque section de ma page, je donne à l’IA :
- Un prompt avec le contexte de la section et ce qui est attendu
- Les données collectées qui peuvent être utilisées
- La section exemple sur laquelle elle peut se calquer
- Des contraintes strictes pour qu’elle écrive comme un humain : pas de tirets cadratins, pas de statistiques inventées, répondre à la question dès la première phrase de chaque réponse de la FAQ. J’ai amélioré cette liste au fil du temps
- Un script lit aussi le sitemap et fournit 10 liens internes qu’il pourrait être pertinent d’ajouter
Étape 5. Le contrôle qualité. Un script vérifie le résultat.
- Les entreprises citées existent-elles vraiment dans les données ?
- Les décomptes correspondent-ils à la base de données ?
- Des mots interdits ?
- Des liens morts ?
Si le contrôle échoue, l’agent corrige la page, pas le validateur. Cette règle est écrite noir sur blanc : « Ne modifie pas le validateur pour le faire passer. »
Étape 6. Ouvrir une pull request. Rien ne se publie tout seul. Je relis chaque page avant sa mise en ligne, ce qui prend environ 30 secondes chaque matin.
Et voilà, votre page est en ligne !
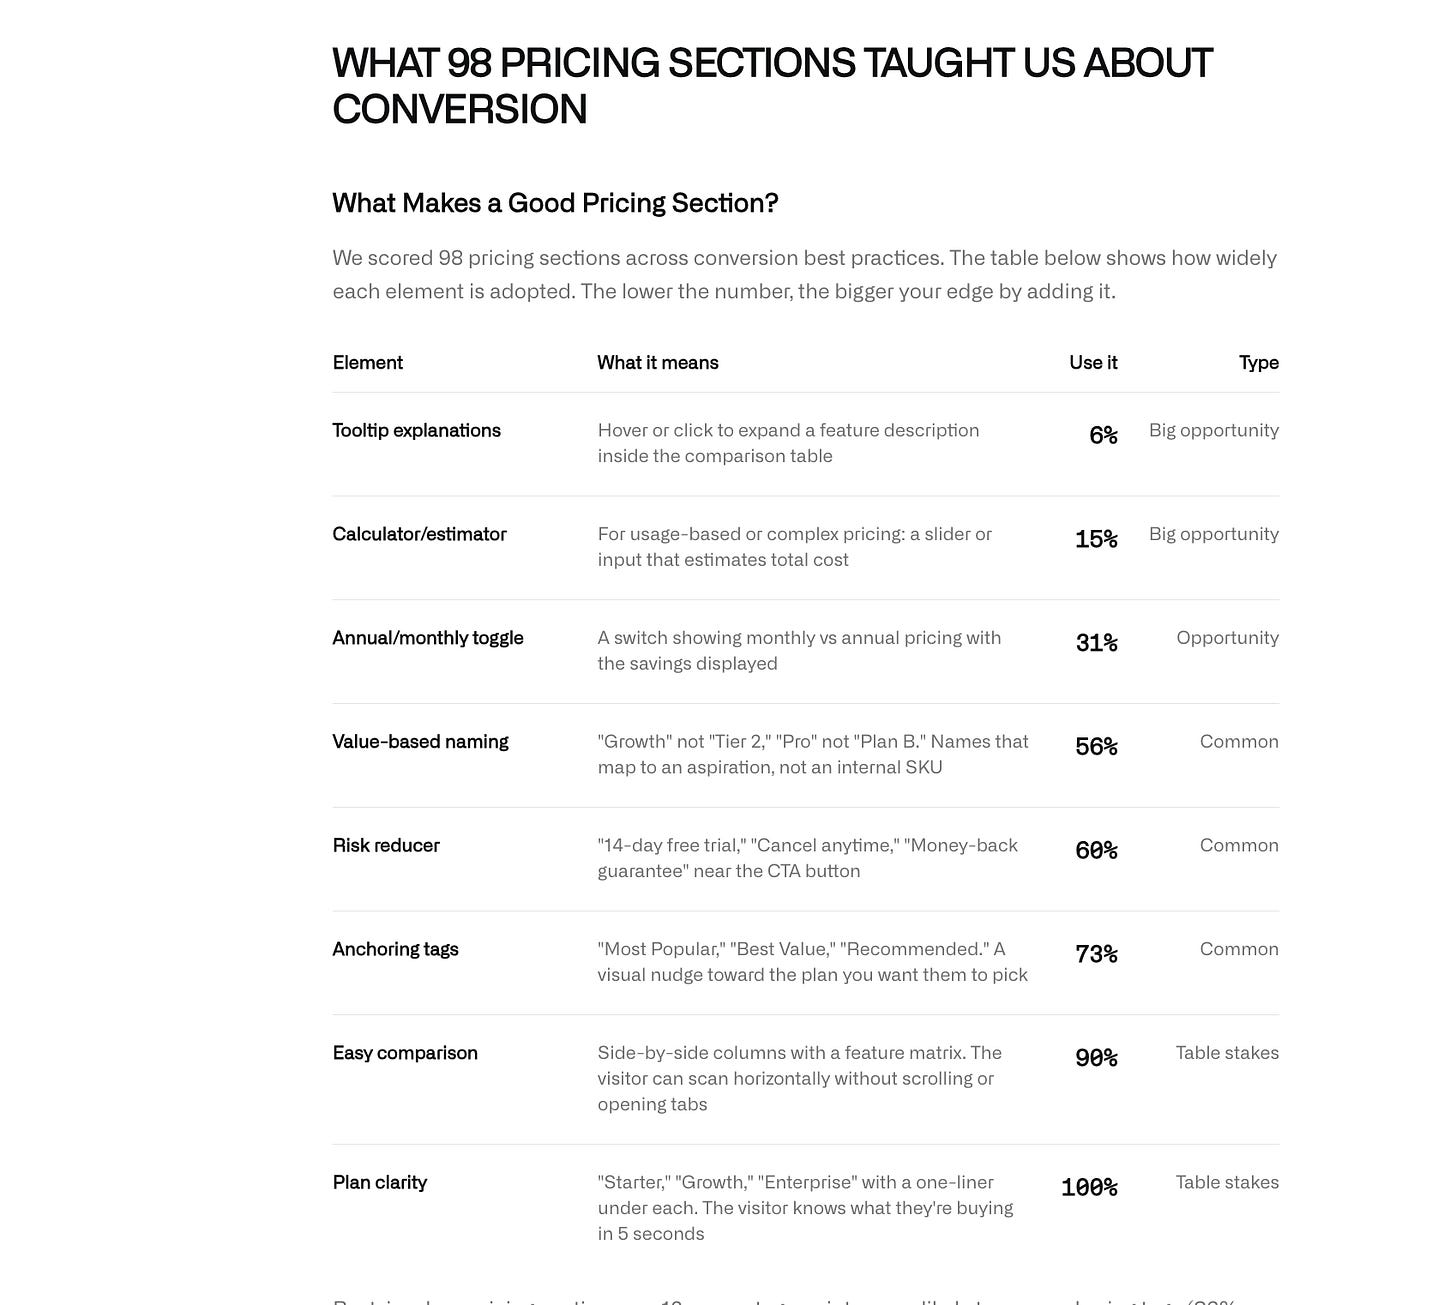
| Élément | Ce que ça veut dire | Utilisé par | Type |
|---|---|---|---|
| Infobulles d’explication | Survoler ou cliquer pour déplier la description d’une fonctionnalité dans le tableau comparatif | 6 % | Grosse opportunité |
| Calculateur/estimateur | Pour une tarification à l’usage ou complexe : un curseur ou un champ qui estime le coût total | 15 % | Grosse opportunité |
| Bascule annuel/mensuel | Un interrupteur qui montre le prix mensuel ou annuel avec l’économie affichée | 31 % | Opportunité |
| Noms orientés valeur | « Growth » plutôt que « Tier 2 », « Pro » plutôt que « Plan B ». Des noms qui renvoient à une aspiration, pas à une référence interne | 56 % | Courant |
| Réducteur de risque | « 14 jours d’essai gratuit », « Résiliable à tout moment », « Satisfait ou remboursé » près du bouton | 60 % | Courant |
| Badges d’ancrage | « Le plus populaire », « Meilleur rapport qualité-prix », « Recommandé ». Un coup de pouce visuel vers l’offre que vous voulez faire choisir | 73 % | Courant |
| Comparaison facile | Des colonnes côte à côte avec une matrice de fonctionnalités. Le visiteur compare d’un coup d’œil, sans faire défiler ni ouvrir d’onglets | 90 % | Indispensable |
| Offres claires | « Starter », « Growth », « Enterprise » avec une phrase sous chacune. Le visiteur sait ce qu’il achète en 5 secondes | 100 % | Indispensable |
Pièce 4 : automatiser le contenu SEO avec une routine quotidienne
La dernière étape consiste à créer une tâche récurrente qui tourne chaque jour. Claude propose ce qu’ils appellent des routines : des actions récurrentes que vous définissez une fois et laissez tourner selon un calendrier.
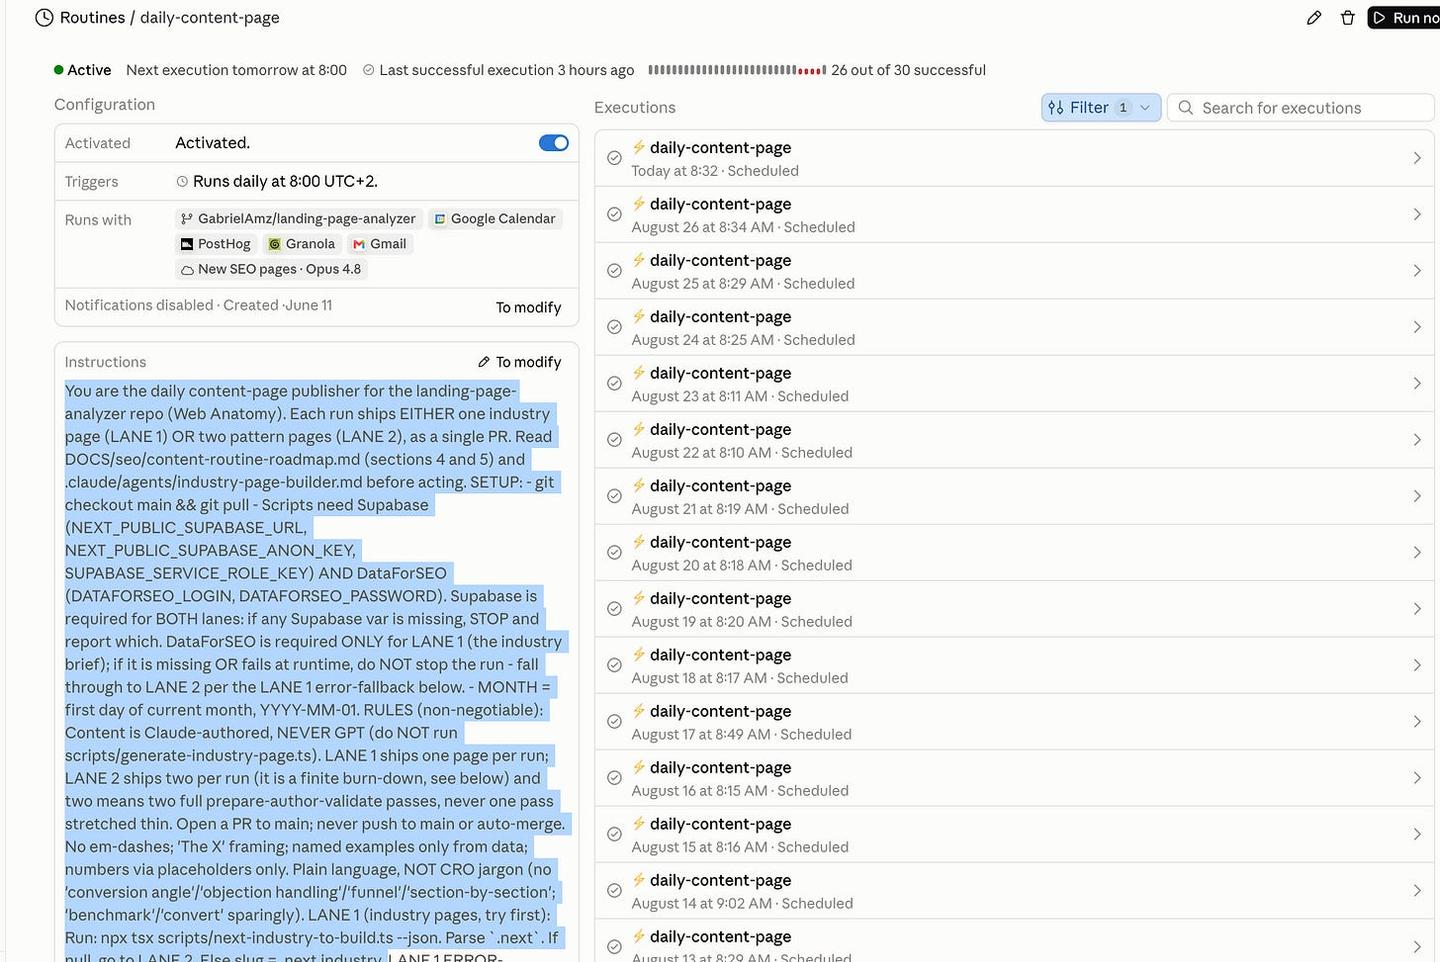
Ce qu’elle fait chaque jour : lire la roadmap, puis appeler deux choses.
- Supabase, pour récupérer mes données de sections et de pages
- DataForSEO, pour récupérer les informations SEO
Je la fais tourner directement dans mon chat Claude, donc sans coût d’API supplémentaire.
Les règles
Quelques leçons apprises en chemin.
Pas de données, pas de page.
La règle la plus importante du système, c’est qu’il ne produit pas de déchets.
Chaque type de page a un « seuil » : un nombre minimum d’exemples réels dont j’ai besoin avant que la page ait le droit d’exister. Pour mes pages de patterns, le seuil est de 3 exemples nommés tirés du benchmark. Si un pattern n’en a que 2, le script s’arrête et la page n’est pas construite.
Les permissions de l’IA.
Pour éviter les hallucinations, mes skills retirent à l’IA le droit d’aller chercher quoi que ce soit sur le web. La seule information qu’elle a le droit d’utiliser, ce sont mes propres données.
Alors, l’indexation a-t-elle vraiment marché ?
Oui. En septembre 2026, 90 % de mes pages étaient indexées.
Ça peut sembler lent, mais les pages sont indexées, et petit à petit je pourrai publier 1, 2, 3, peut-être 10 nouvelles pages chaque jour.
Mon objectif avec Web Anatomy est de construire une marque sur le long terme, donc je peux attendre :)
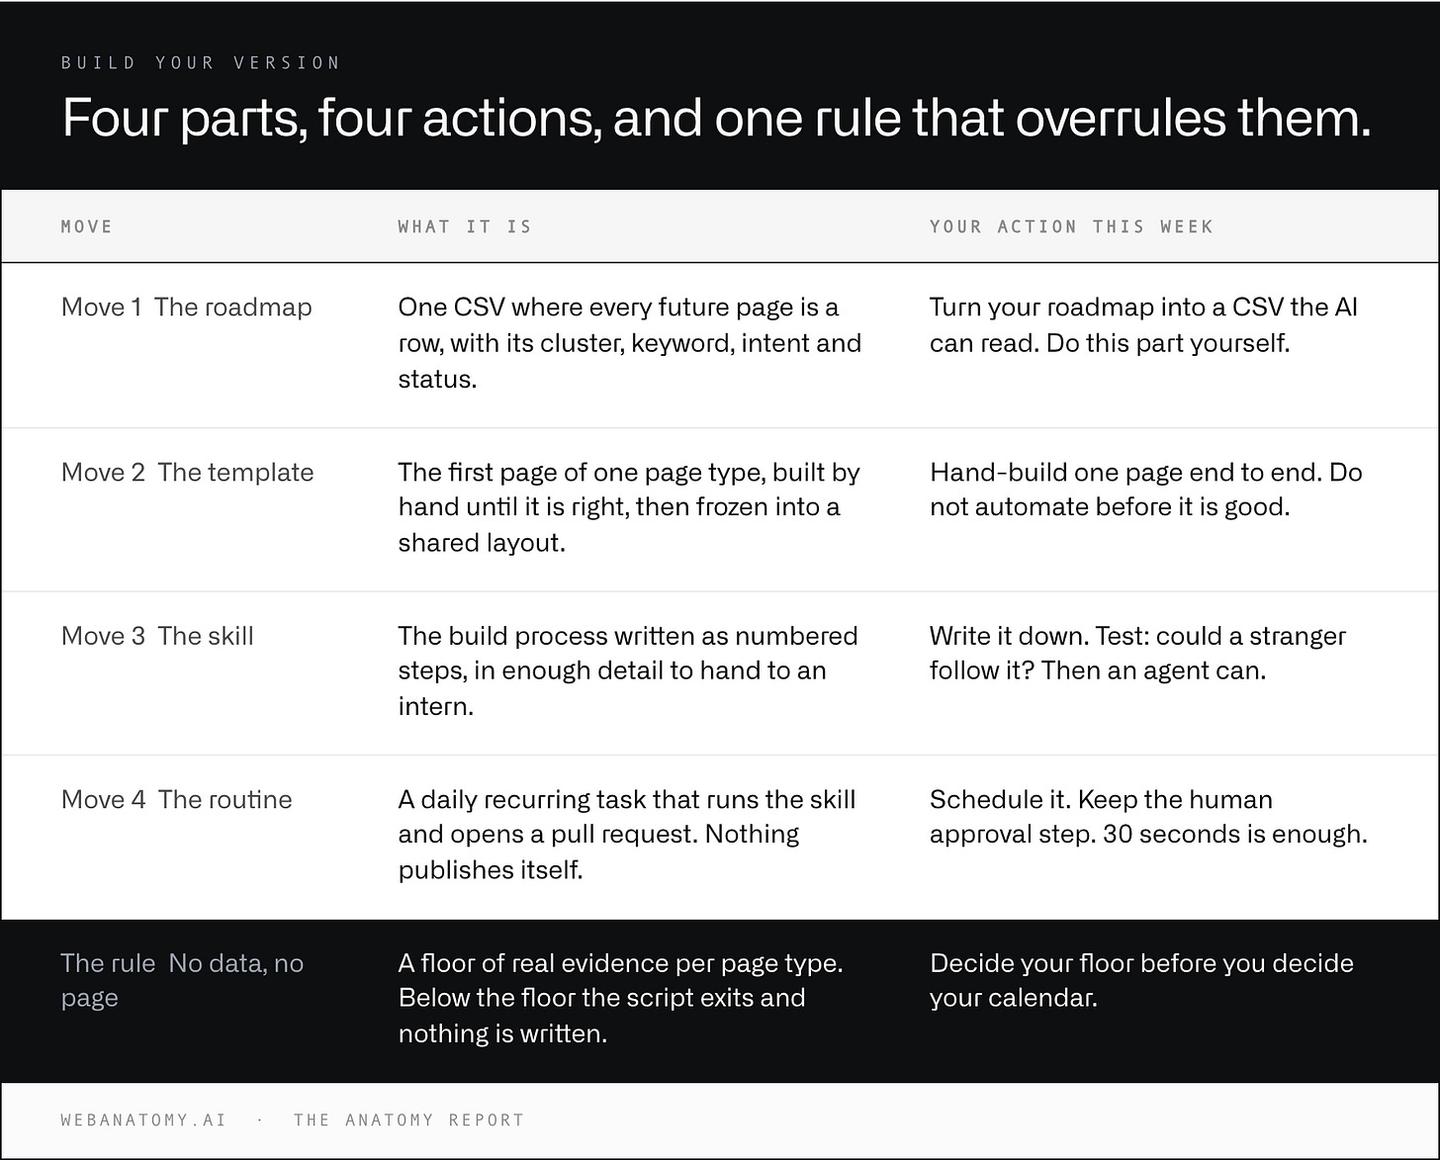
| Pièce | Ce que c’est | Votre action cette semaine |
|---|---|---|
| Pièce 1 : la roadmap | Un CSV où chaque future page est une ligne, avec son cluster, son mot-clé, son intention et son statut. | Transformez votre roadmap en un CSV que l’IA peut lire. Faites cette partie vous-même. |
| Pièce 2 : le template | La première page d’un type de page, construite à la main jusqu’à ce qu’elle soit juste, puis figée dans une mise en page partagée. | Construisez une page de bout en bout à la main. N’automatisez pas avant qu’elle soit bonne. |
| Pièce 3 : la skill | Le processus de construction écrit en étapes numérotées, avec assez de détails pour le confier à un stagiaire. | Écrivez-le. Le test : un inconnu pourrait-il le suivre ? Alors un agent le peut. |
| Pièce 4 : la routine | Une tâche quotidienne qui exécute la skill et ouvre une pull request. Rien ne se publie tout seul. | Planifiez-la. Gardez l’étape de validation humaine. 30 secondes suffisent. |
| La règle : pas de données, pas de page | Un seuil de preuves réelles par type de page. Sous le seuil, le script s’arrête et rien n’est écrit. | Fixez votre seuil avant de fixer votre calendrier. |
Reprenez ce workflow de contenu SEO avec l’IA
1. Construisez d’abord la roadmap (1 jour). Un seul tableur. Colonnes : chemin, type de page, mot-clé principal, intention, statut. Listez toutes les pages que votre site devrait avoir dans 3 mois. Si vous n’arrivez pas à remplir 30 lignes, votre problème est la stratégie, pas la production de contenu.
2. Construisez à la main la première page d’UN type de page (une demi-journée). Choisissez votre type de page le plus répétable et construisez une page à la main, de bout en bout. Puis transformez sa mise en page en template réutilisable.
3. Écrivez le fichier de skill (1 heure). Écrivez la logique en étapes numérotées : d’où viennent les données, ce que la page doit contenir, et vos règles de ton comme contraintes strictes.
4. Ajoutez un seuil et un garde-fou (1 heure). Fixez le minimum de preuves dont une page a besoin et refusez de construire en dessous. Puis écrivez une checklist que l’agent doit passer sur son propre travail avant que vous le voyiez.
Pour le côté template de la même idée, à l’échelle de centaines de pages, lisez le guide pratique du SEO programmatique.
Quel résultat attendez-vous de votre site ?
Choisissez votre priorité. Nous définissons ensemble l’objectif, les actions et la mesure des résultats.
Construisez un canal d’acquisition autour des recherches de vos prospects. Découvrez notre accompagnement SEO, de la roadmap et du premier modèle de page à la production quotidienne et au suivi des résultats.
Adapté de How to publish one page a day without publishing slop, publié dans la newsletter Web Anatomy le 2 septembre 2026.
Écrit par
Gabriel Amzallag , Fondateur, Web Anatomy
5 ans CRO + SEO chez Qonto (2021–2025). Après avoir conseillé 15+ SaaS sur leurs sites (Payfit, Pigment…), les mêmes patterns cassaient — alors j'ai décidé de construire la source de vérité sur ce qui fonctionne sur le web : la couche d'intelligence que chaque outil, builder et équipe utilise pour créer des sites qui performent.
À lire aussi
Playbooks
Nous avons analysé les publicités des plus grosses entreprises EdTech. Voici ce qui fonctionne.
Les publicités EdTech qui ont duré pendant l'été 2026, les huit angles qu'elles utilisent et les pages derrière elles. Les enseignements, avec les publicités à regarder.
 Gabriel Amzallag26 min de lecture
Guides
Comment améliorer le taux de conversion de votre site (au lieu de courir après le trafic)
Vous n'avez pas besoin de plus de trafic. Une méthode simple pour améliorer le taux de conversion de votre site : savoir si ça vaut le coup, trouver des idées à trois niveaux, les classer avec RICE et mesurer chaque changement.
Gabriel Amzallag8 min de lecturePlaybooks
Nous avons analysé les publicités des grands outils de design. Voici ce qui marche.
Les neuf angles des publicités outils de design qui durent, les cinq que personne n'utilise, et les pages derrière les clics. Huit annonceurs, 229 annonces Meta, un relevé.
Gabriel Amzallag27 min de lecture